






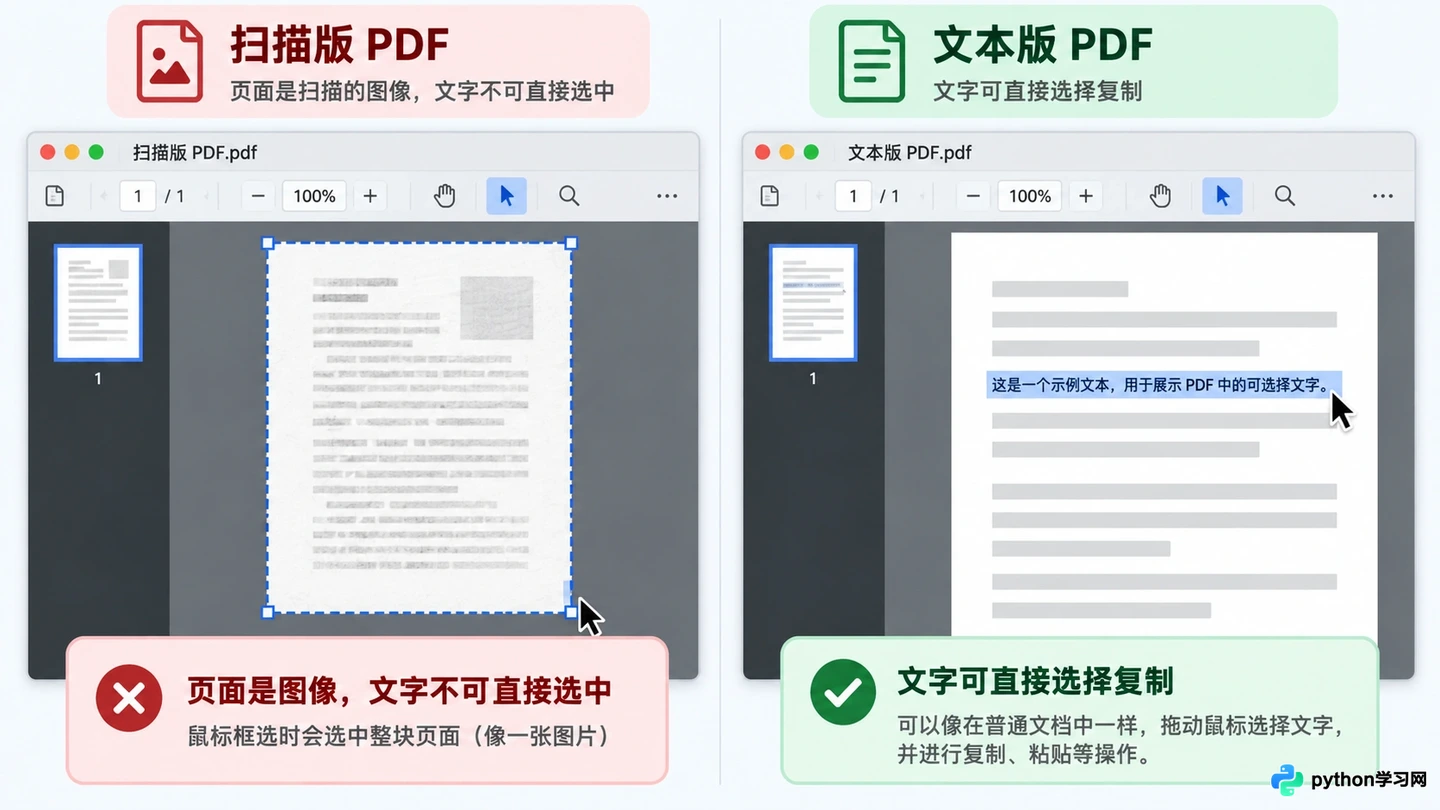
扫描版PDF怎么翻译?结合OCR与AI实现高精度图文转换
针对无法直接复制文字的扫描版PDF,本教程演示如何结合OCR识别与AI大模型,实现保留排版的高精度图文翻译。通过提取文本、调用AI翻译及重新排版,解决图片型文档的跨语言阅读难题。
2026-11-01
4
def hello(name): return f"Hello, {name}!"for name in ["Python", "Data", "AI"]: print(hello(name))# 点击运行代码,进入在线编辑器Hello, Python! Hello, Data! Hello, AI!
针对无法直接复制文字的扫描版PDF,本教程演示如何结合OCR识别与AI大模型,实现保留排版的高精度图文翻译。通过提取文本、调用AI翻译及重新排版,解决图片型文档的跨语言阅读难题。
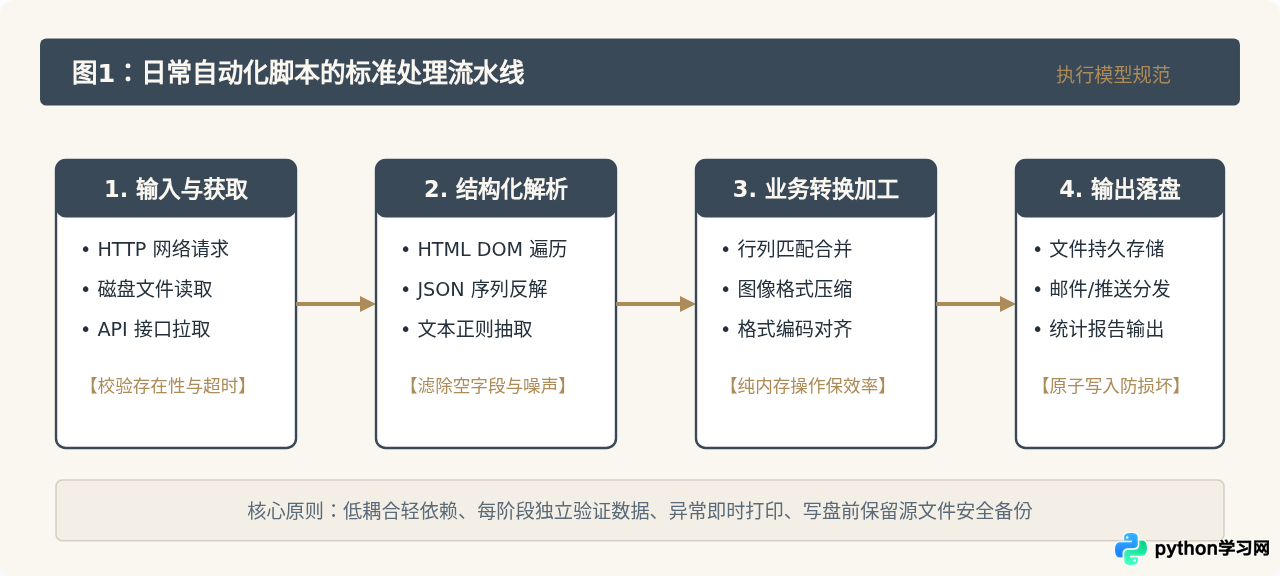
精选10个面向日常办公与数据运维的Python实用短脚本,覆盖静态网页抓取、文件整理、表格合并、格式转换及系统清理,提供完整代码与落地注意事项。
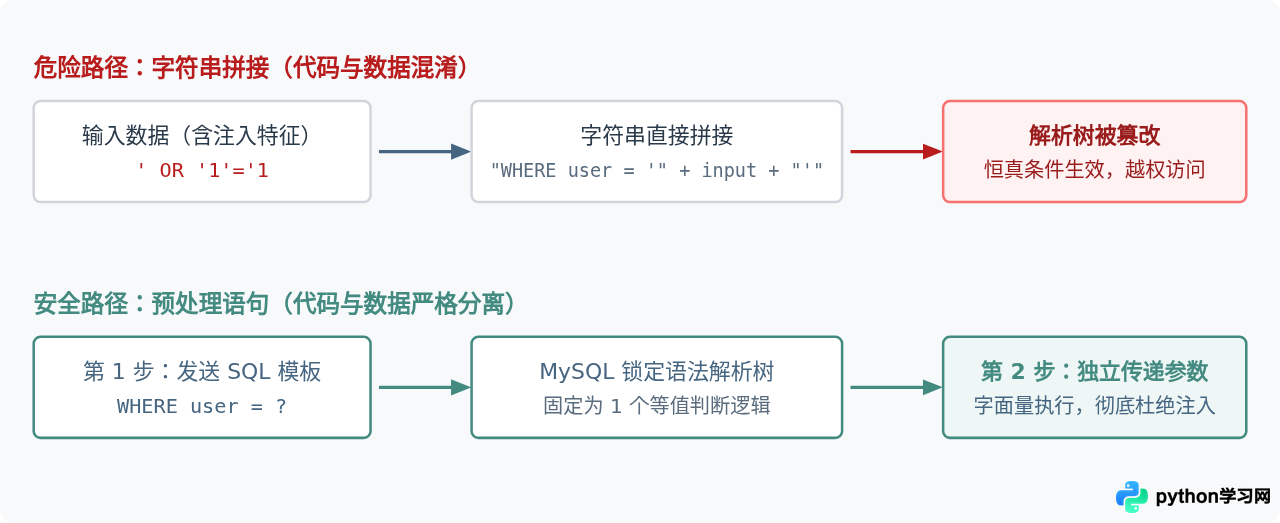
针对MySQL增删改查(CRUD)操作中常见的SQL注入风险,详细讲解预处理语句与参数化查询的实现机制、规范代码示例及白名单防御策略。
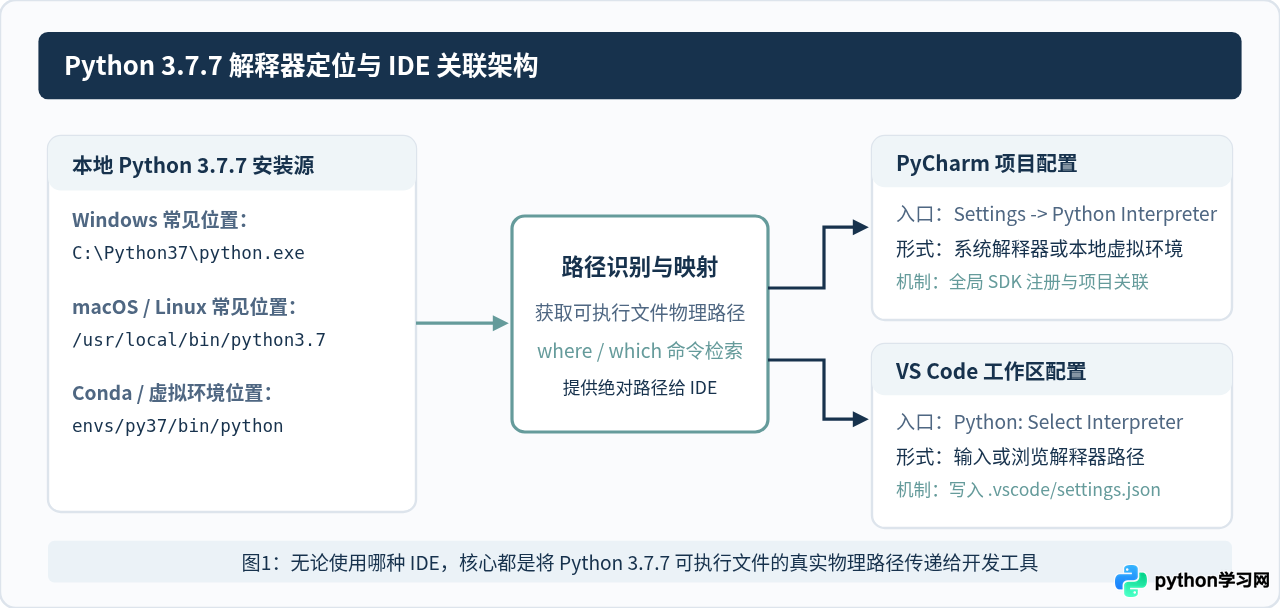
详细讲解在PyCharm与VS Code中查找、绑定与验证Python 3.7.7解释器的完整操作步骤、配置文件机制以及常见问题的排查方法。
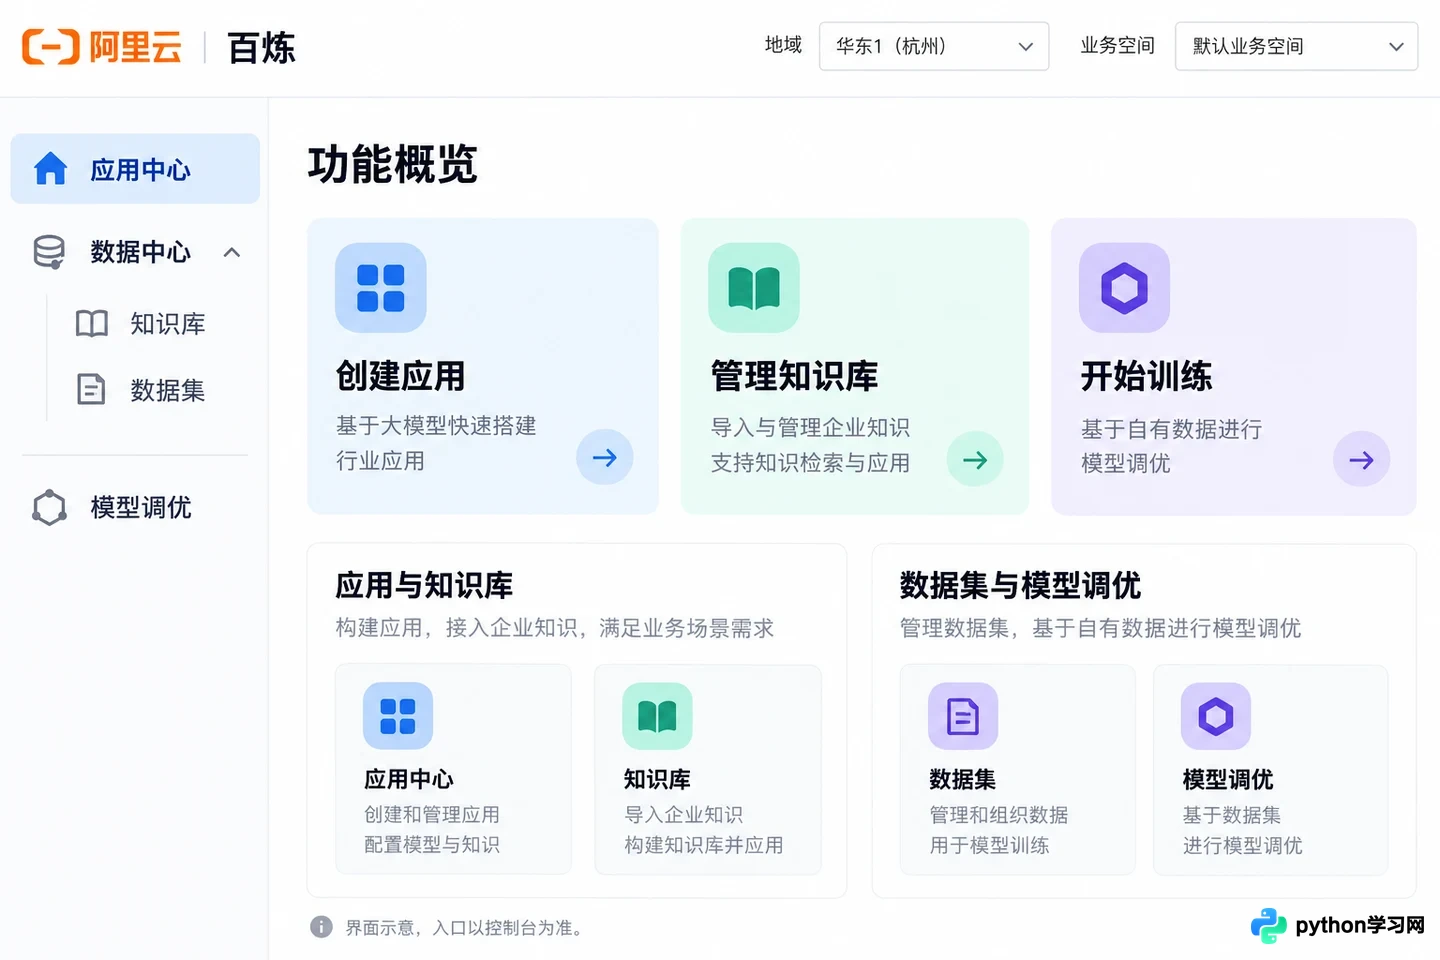
本文以阿里云百炼控制台为例,解析大模型开发中的关键界面模块。通过区分“应用与知识库”和“数据集与模型调优”两条主线,介绍如何配置RAG检索增强生成应用,以及如何准备数据并进行SFT微调,帮助开发者理清从知识接入到模型优化的完整链路。
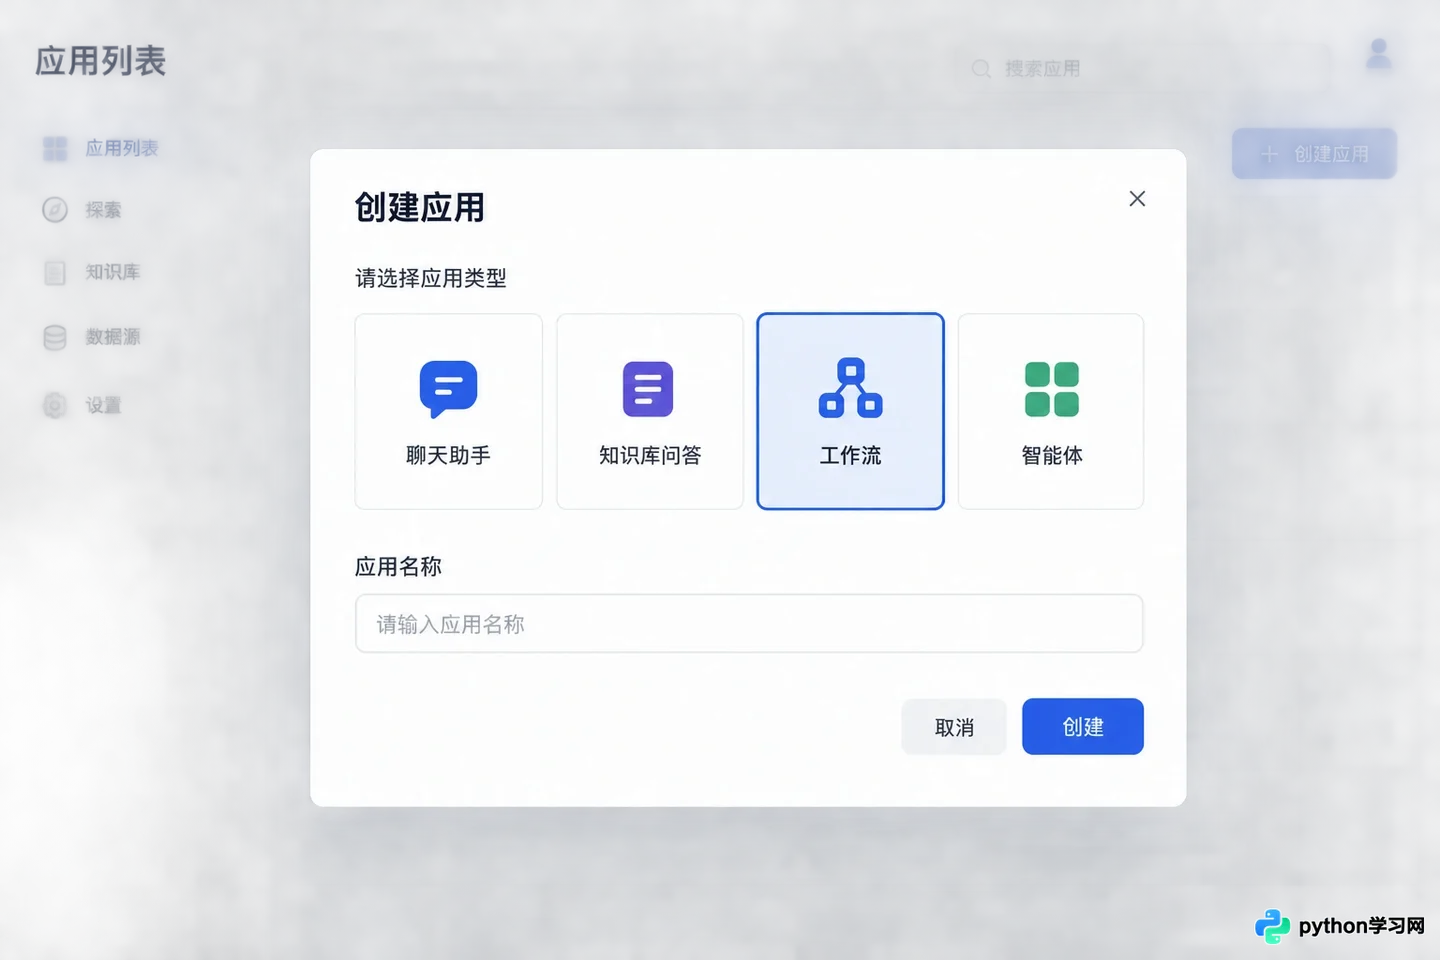
本文介绍如何使用Dify平台的可视化工作流功能,通过拖拽组件和配置参数,零代码构建具备业务逻辑的AI智能体。涵盖从创建应用、设计工作流节点到测试发布的完整流程,适合非技术人员快速上手。
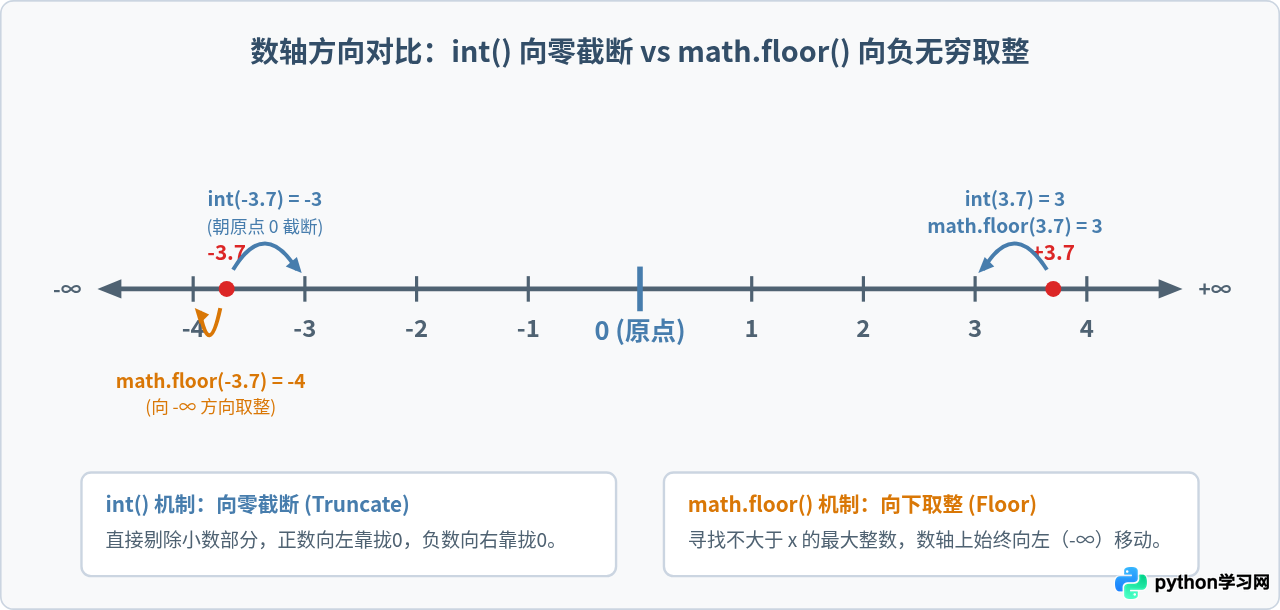
深入分析Python中int()截断取整与math.floor()向下取整的核心区别,涵盖正负数取整差异、数轴直观对比、底层魔术方法机制及实际业务选型指南。
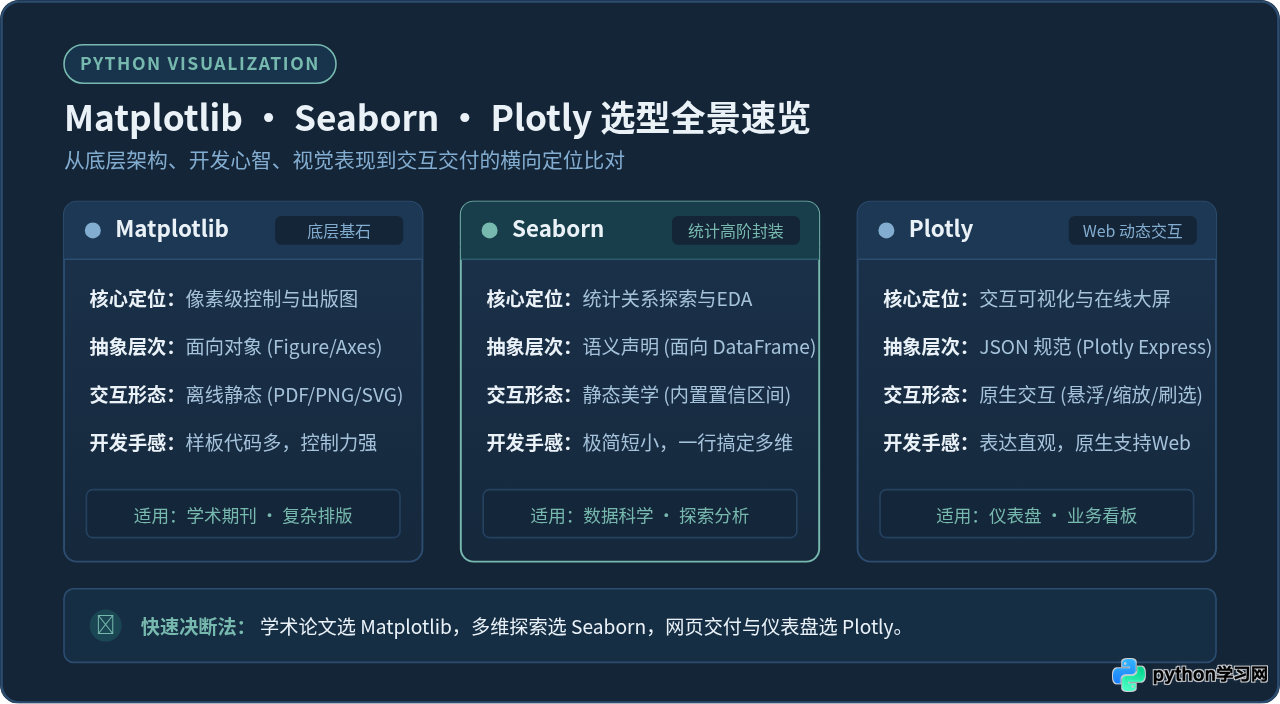
全面对比分析 Python 三大主流可视化库 Matplotlib、Seaborn 与 Plotly:从底层架构、编码效率、美学表现、交互交付及性能表现进行五维解剖,并提供四步决策流程与典型场景选型指南。
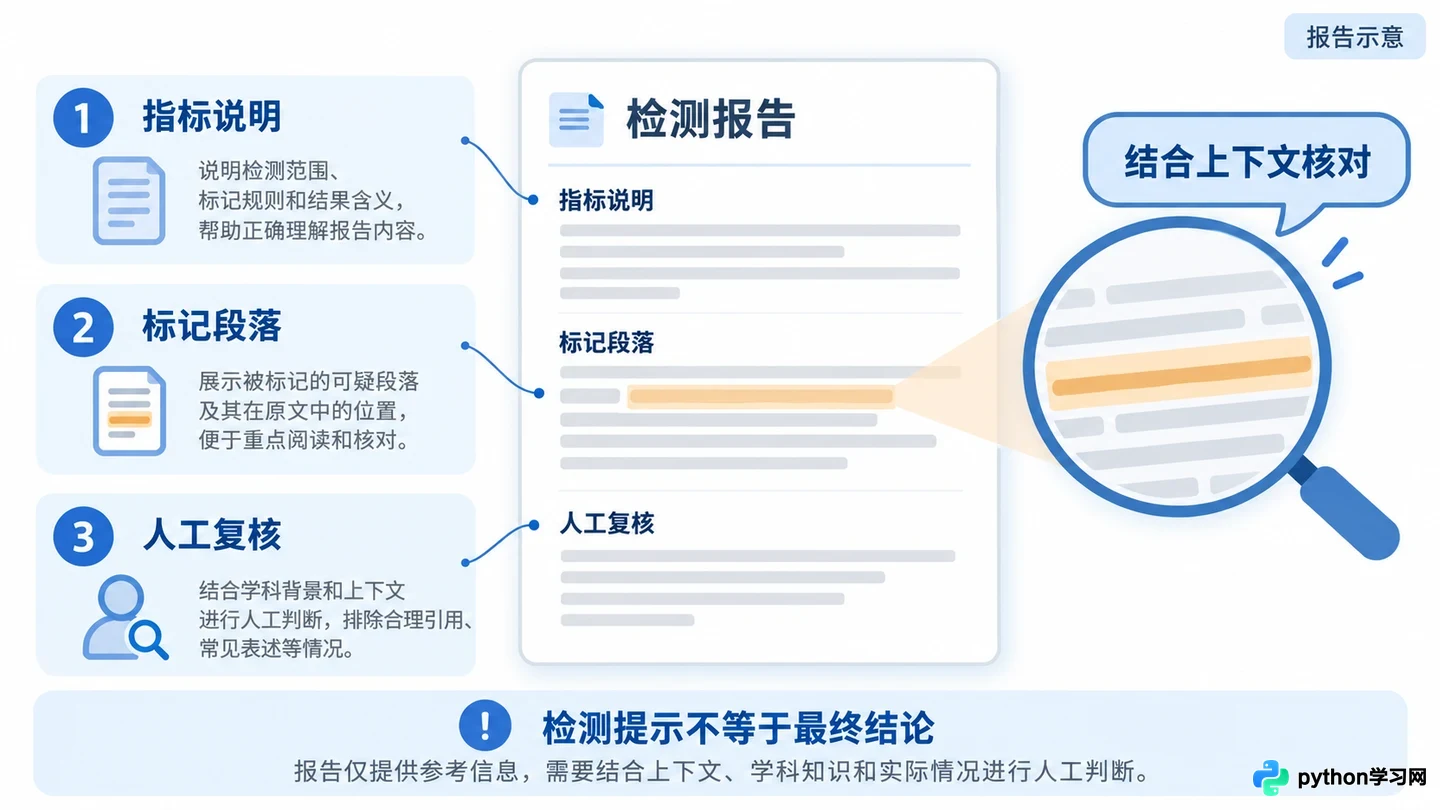
本文以Turnitin AI写作报告为例,指导用户如何正确解读AI检测数据。通过核对报告有效性、区分AI比例与相似度、定位标记段落以及结合写作过程材料进行人工复核,帮助用户避免误读指标,建立科学的学术诚信审查流程。
本文详细讲解如何在Python中使用scipy.stats模块进行单样本、独立双样本以及配对样本t检验,计算t统计量与p值,并深入解析计算原理、参数设置与结果判定。